你深夜搜的那个 MySQL 报错,全世界都在搜。
我把 Stack Overflow、DBA Stack Exchange、知乎、V2EX 上 MySQL 相关的高频实战问题做了一次盘点(热度数据经 Stack Exchange 官方 API 实测抓取),发现一个有意思的事实:"连不上库"这一个主题下的报错,在 Stack Overflow 上累计浏览量接近一千万;而中文社区情绪浓度最高的话题,是"误删数据怎么恢复"——V2EX 上一篇《死了,客户的数据被删光了》有近两万浏览、157 条回复。
这些问题高度收敛。连接报错、慢查询、锁冲突、误删恢复、中文乱码——全球开发者和中文开发者踩的是同一批坑。这篇文章把这些坑整理成一份按症状索引的操作手册:每个问题给出一句话根因、排查命令、修复动作,直接可执行。
问题全景:五大症状
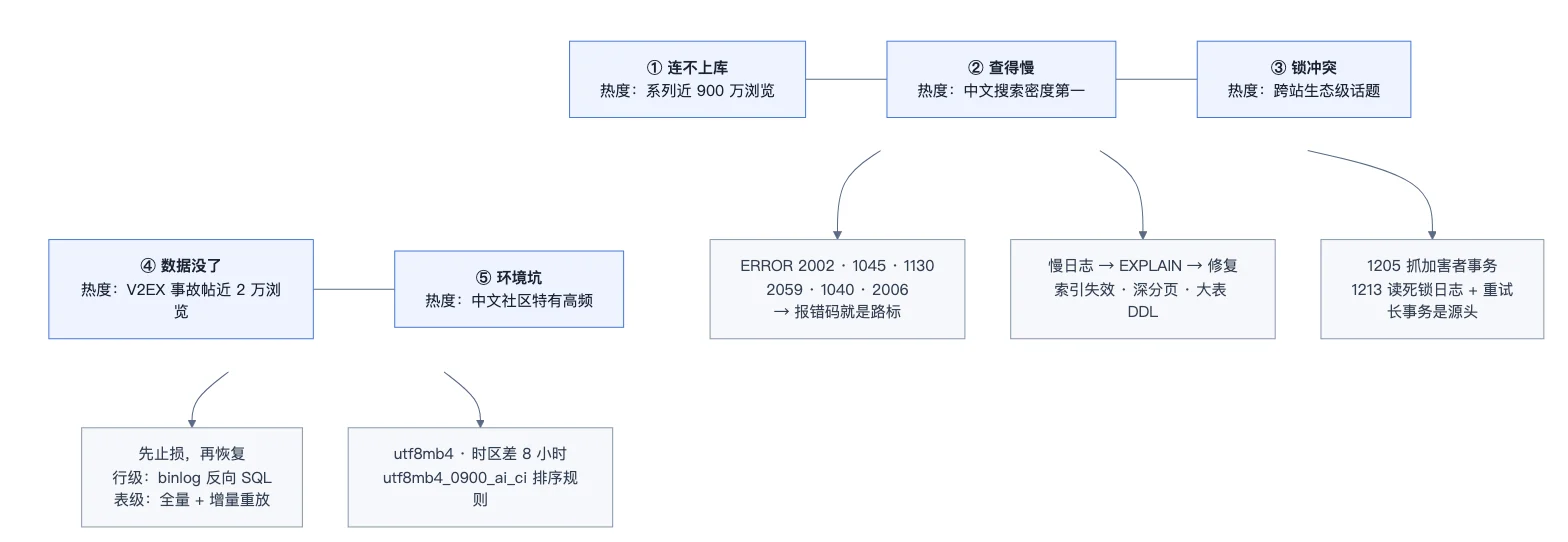
按热度证据,所有高频问题收敛为五大症状:
下面逐个展开。
一、连不上库:报错码就是路标
连接类问题的总原则:先看报错码,再判断问题在哪一层——服务没起来、网络不通、认证失败,三条路径完全不同。
ERROR 2002:Can't connect to local MySQL server through socket
本地连接最常见的报错。两层含义:要么 mysqld 根本没在跑,要么在跑但 socket 文件路径和客户端配置对不上。
# 第一步:确认 mysqld 活着没有
ps aux | grep mysqld
systemctl status mysqld        # 或 mysql / mariadb,看发行版

# 第二步:服务端 socket 在哪
mysqladmin -u root -p variables | grep socket

# 第三步:绕过 socket,走 TCP 连(能连上就说明只是路径问题)
mysql -h 127.0.0.1 -P 3306 -u root -p
如果 TCP 能连:在 my.cnf 的 [client] 段把 socket 改成服务端实际的路径即可。macOS 上用 Homebrew 装的 MySQL、XAMPP/MAMP 集成环境,是这个问题的高发区——升级后 socket 路径变更,客户端还拿着旧配置。
ERROR 1045:Access denied for user
认证失败。四种场景按概率排查:
密码确实错了——包括密码里有
!、$等 shell 特殊字符没转义。用户和主机不匹配。MySQL 按
user@host精确匹配,'root'@'localhost'和'root'@'%'是两个账号。这里有个经典陷阱:如果表里存在匿名用户(user为空的行),mysql.user的匹配规则会让匿名行优先命中,导致"账号存在、密码正确"也进不去。Ubuntu 系 auth_socket 陷阱:Debian/Ubuntu 默认给 root 配了
auth_socket插件,要求系统用户和数据库名一致。mysql -u root -p进不去,但sudo mysql直接进——如果你遇到 ERROR 1698,就是它。8.0 认证插件不兼容(报 2059,见下文)。
查清到底匹配到了哪个账号:
SELECT user, host, plugin FROM mysql.user;
-- 看有没有 user 为空的行,有就删掉:
DROP USER ''@'localhost';
忘记 root 密码:标准重置流程
# 1. 停库,用跳过权限模式启动(务必同时关网络,防止重置窗口期被远程连入)
systemctl stop mysqld
mysqld_safe --skip-grant-tables --skip-networking &

# 2. 免密进入,重置密码(8.0 语法)
mysql -u root
ALTER USER 'root'@'localhost' IDENTIFIED BY '新密码';
FLUSH PRIVILEGES;
EXIT;

# 3. 杀掉安全模式进程,正常启动
mysqladmin -u root -p shutdown
systemctl start mysqld
注意 5.7 和 8.0 的改密语法有差异(SET PASSWORD FOR ... = PASSWORD('...') 在 8.0 已移除),网上老教程直接照抄会报语法错。Windows 下用服务方式运行的,在服务参数里临时加 --skip-grant-tables 或用 --init-file 指向一条改密 SQL,改完务必撤掉。
ERROR 1130:Host 'x.x.x.x' is not allowed to connect
远程连接被拒,服务端明确告诉你"这个来源主机没授权"。三件事做全:
-- 1. 建账号并授权(8.0 必须先建号再授权,不能一条语句搞定)
CREATE USER 'app'@'192.168.1.%' IDENTIFIED BY '强密码';
GRANT SELECT, INSERT, UPDATE, DELETE ON mydb.* TO 'app'@'192.168.1.%';
FLUSH PRIVILEGES;   -- 直接用 GRANT 授权时不需要;手工改 mysql.user 表时必须
# 2. 解除监听限制:默认 bind-address 往往是 127.0.0.1,改成 0.0.0.0 或内网 IP
grep bind-address /etc/mysql/mysql.conf.d/mysqld.cnf

# 3. 放行防火墙 / 云安全组的 3306 端口
安全提醒:不要图省事建 'root'@'%' 加弱密码——这是被勒索软件扫库的标准入口。应用账号按最小权限给。
ERROR 2059:Authentication plugin 'caching_sha2_password' cannot be loaded
MySQL 8.0 把默认认证插件换成了 caching_sha2_password,老版本 Navicat、PHP 5.x、老 JDBC 驱动不认。两条路:
-- 临时:把这个账号退回老插件
ALTER USER 'root'@'localhost' IDENTIFIED WITH mysql_native_password BY '密码';
长期方案是升级客户端——mysql_native_password 在 8.4 起默认关闭,回退插件只是争取时间,不是终点。
ERROR 1040:Too many connections
连接打满时,普通账号连管理通道都挤不进去。MySQL 给有 CONNECTION_ADMIN 权限的账号预留了额外连接,所以第一件事是用管理员账号挤进去:
SET GLOBAL max_connections = 500;          -- 临时抬上限止血

SHOW PROCESSLIST;                           -- 找 Sleep 大户
SELECT user, COUNT(*) c FROM information_schema.processlist
GROUP BY user ORDER BY c DESC;

KILL <id>;                                  -- 清理泄漏连接
治本在应用侧:连接池上限、空闲回收(wait_timeout)、慢 SQL 挤占连接——max_connections 每个连接都吃内存,无脑调大只会把实例推向 OOM。
ERROR 2006:MySQL server has gone away
三大原因,各自验证:
二、查得慢:三板斧流程
慢查询优化有标准动作链:慢日志圈范围 → EXPLAIN 定原因 → 索引/改写/参数三线修复。
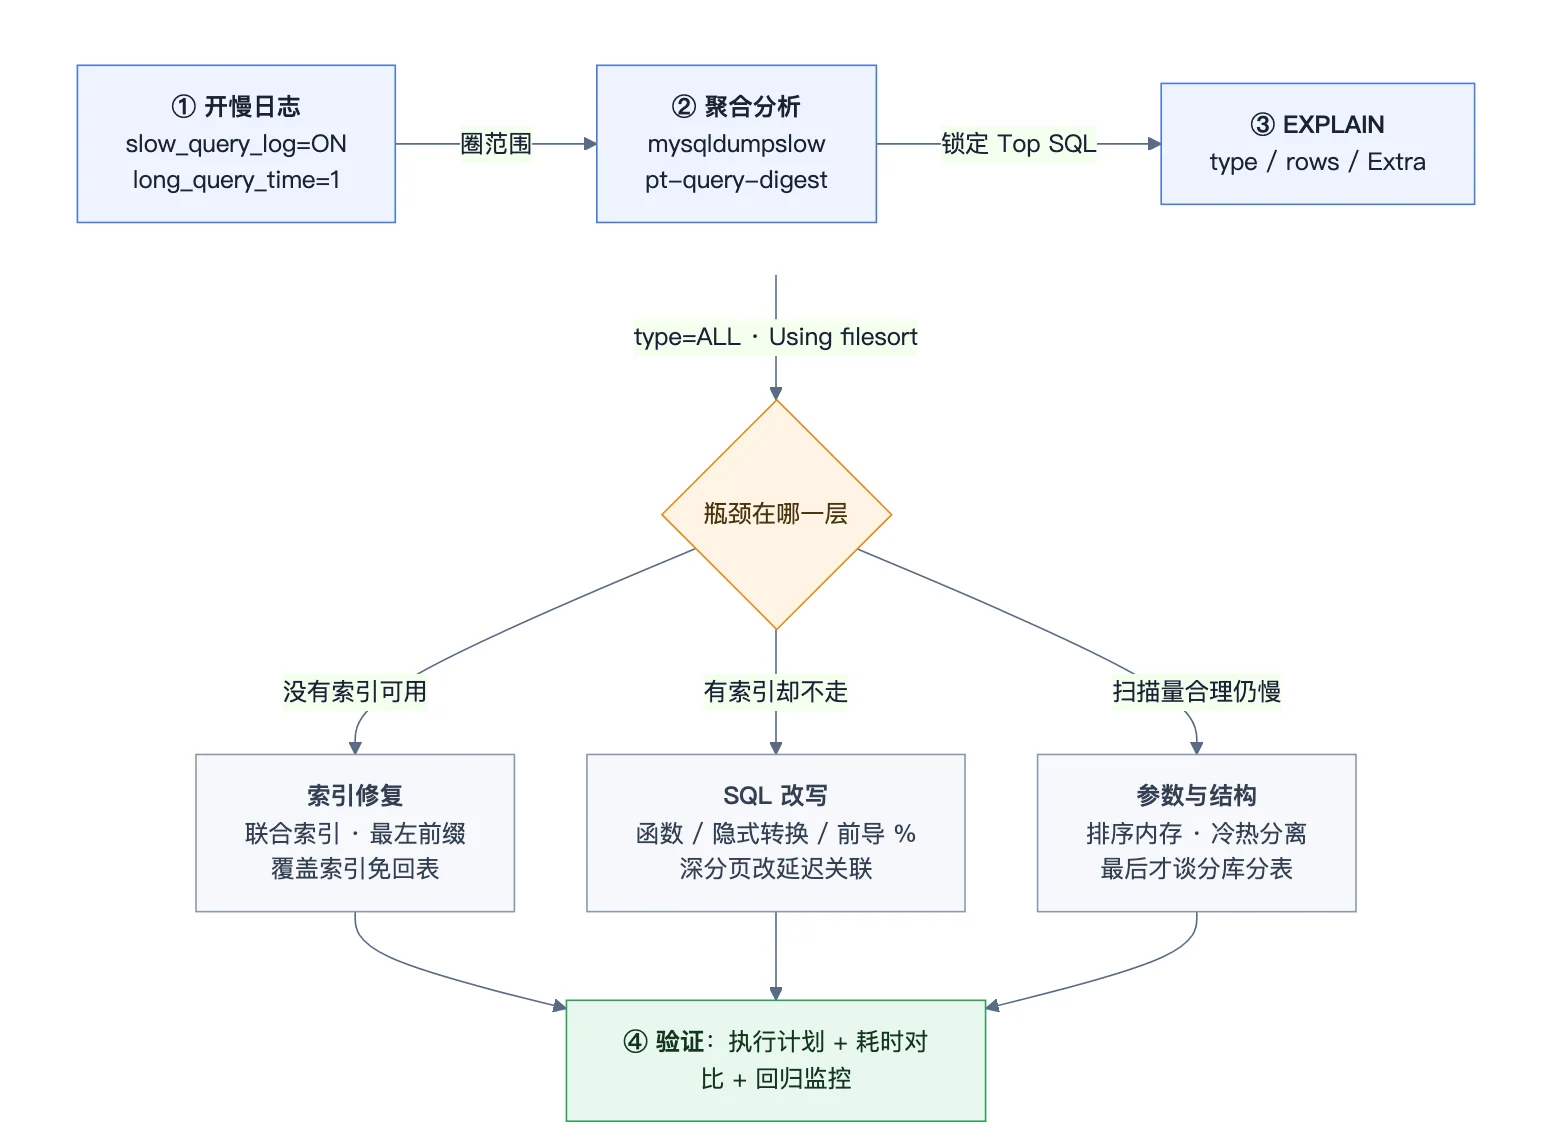
第一步:让慢 SQL 自己浮出来
-- 8.0 可以不重启在线开(SET PERSIST 会同时写配置文件,重启后仍生效)
SET PERSIST slow_query_log = ON;
SET PERSIST long_query_time = 1;    -- 超过 1 秒记入慢日志
SHOW VARIABLES LIKE 'slow_query_log_file';
然后聚合分析,别一条条肉眼翻:
mysqldumpslow -s t -t 10 /var/lib/mysql/xxx-slow.log   # 按总耗时排 Top 10
# 或者用更强大的 pt-query-digest(Percona Toolkit)
pt-query-digest /var/lib/mysql/xxx-slow.log | head -50
第二步:EXPLAIN 看执行计划
EXPLAIN SELECT ...;
三个字段定生死:
type(访问方式):好到差的顺序
const > eq_ref > ref > range > index > ALL。出现ALL就是全表扫描,大表上必慢。rows:优化器估算的扫描行数,数量级比精度重要。
Extra:
Using index是好信号(覆盖索引,不用回表);Using filesort(额外排序)和Using temporary(临时表)是重点优化对象。
索引失效高频场景清单
"明明加了索引为什么不走"是知乎 37 个回答、最高赞 354 的问题。失效场景收敛为这几类:
最后一类最重要:索引不生效有时是优化器的理性选择。先用 EXPLAIN 确认扫描行数,再决定是改索引还是改 SQL。
深分页:LIMIT 1000000, 10 为什么慢
LIMIT 1000000, 10 会扫过前 100 万行再丢弃,越翻越慢。两种主流解法:
-- 方案一:延迟关联——先用覆盖索引把目标 id 圈出来,再回表取整行
SELECT t.* FROM orders t
JOIN (SELECT id FROM orders ORDER BY id LIMIT 1000000, 10) x
  ON t.id = x.id;

-- 方案二:游标分页(键集分页)——记住上一页末尾 id,性能与页深无关
SELECT * FROM orders WHERE id > #{last_id} ORDER BY id LIMIT 10;
游标分页性能最好,但要求排序键唯一有序、只支持顺序翻页——产品上"跳转到第 N 页"的功能要一起改。后台列表、导出接口优先用它。
大表 DDL:加字段/加索引会不会锁表
知乎 2015 年的一个问题至今还在被搜索,其中有个高赞回答是真实事故:2 亿行的表在线加字段,锁表引发 SQL 排队,内存占满,OOM,服务崩溃。
版本决定行为:
两个实操要点:
-- 1. 显式声明算法和锁级别——不满足时直接报错,而不是静默降级成锁表操作
ALTER TABLE big_table ADD COLUMN remark VARCHAR(200),
  ALGORITHM=INSTANT, LOCK=NONE;

-- 2. DDL 之前先看有没有长事务——DDL 要拿元数据锁(MDL),
--    被长事务堵住后,它会反过来堵住后面所有的查询,形成"一夫当关"
SELECT * FROM information_schema.innodb_trx
ORDER BY trx_started LIMIT 5;
什么时候分库分表
单表 1000 万~5000 万行是社区反复引用的经验阈值,但它只是经验。正确的顺序是:先把索引和 SQL 优化做到位 → 考虑冷热分离/归档(老数据搬到历史表或数仓)→ 最后才是分库分表。分片键选错、跨库分页、分布式事务、全局 ID,每一个都是新问题,而索引优化一个下午就能做完。
三、锁与死锁:两个报错码的定位路径
ERROR 1205:Lock wait timeout exceeded
一个事务占着锁不放(默认等 50 秒超时),你的 SQL 是受害者。要抓的是加害者:
-- 跑了多久的事务(重点看 trx_started 很早的行)
SELECT trx_id, trx_state, trx_started, trx_mysql_thread_id, trx_query
FROM information_schema.innodb_trx
ORDER BY trx_started;

-- 8.0 锁等待视图:谁堵谁,一目了然
SELECT * FROM sys.innodb_lock_waits;

-- 确认后杀掉阻塞源(注意:大事务 kill 后回滚本身可能很慢)
KILL <trx_mysql_thread_id>;
常见根因:应用异常导致事务没提交(连接泄漏)、一次 UPDATE 百万行的大事务。调大 innodb_lock_wait_timeout 只是延长忍受时间,不解决问题。
ERROR 1213:Deadlock found when trying to get lock
死锁是 InnoDB 检测到环等后主动回滚一方,你的事务被选为牺牲品——所以标准处置是应用层重试,然后按日志降低复发频率:
SHOW ENGINE INNODB STATUS\G
-- 找 LATEST DETECTED DEADLOCK 段:两个事务各自持有(holds)什么锁、在等(waits)什么锁

-- 建议常开:把每次死锁都写进错误日志,留存历史(默认只保留最近一次)
SET PERSIST innodb_print_all_deadlocks = ON;
降低死锁频率的手段,按见效程度排:统一加锁顺序(批量更新时 ORDER BY id)、缩小事务(把非数据库操作挪出事务)、删掉不必要的二级唯一索引(插入冲突死锁的重要来源)。死锁无法根除,只能压低频率——这个预期要先建立。
四、误删数据:先止损,再恢复
误删是情绪浓度最高的话题,也是唯一"平时不练、出事抓瞎"的题型。出事后前 10 分钟的动作决定损失大小:
止损四步(比恢复更重要):
立即停止应用写入(或把库设为只读:
SET GLOBAL super_read_only = ON;),防止误删范围扩大;保护现场:不要动 binlog、不要动备份,记录当前时间和 binlog 位点(
SHOW MASTER STATUS;);评估范围:哪张表、什么时间点、DELETE 还是 DROP;
有从库的先摘掉从库复制——它可能是你最后一份完整数据。
恢复路径按误删类型分:
# 行级误删(DELETE/UPDATE 漏了 WHERE)——前提:binlog 是 ROW 格式
# 用美团开源的 MyFlash 或 binlog2sql 生成反向 SQL,审核后回放
python binlog2sql/binlog2sql.py -h127.0.0.1 -P3306 -uroot -p'***' \
  --start-file='mysql-bin.000123' --start-datetime='2026-08-25 10:00:00' \
  --stop-datetime='2026-08-25 10:05:00' -B \
  -d mydb -t orders > rollback.sql

# 表级误删(DROP TABLE / TRUNCATE)——binlog 里没有反向 SQL 可生成
# 标准路径:最近的全量备份恢复出一个临时实例
#        + mysqlbinlog 重放全量点到事故前的增量
mysqlbinlog --start-datetime='全量备份时间' \
            --stop-datetime='事故前一刻' \
            mysql-bin.0001xx | mysql -h 临时实例 -u root -p mydb
三条纪律:恢复出的数据先在临时库校验行数和抽样比对,确认后再回迁生产;sql_safe_updates 建议在人工会话里默认开启(SET sql_safe_updates = 1;,不带 key 的 UPDATE/DELETE 直接拒绝,Stack Overflow 上这个报错单题 341 万浏览,说明大量 GUI 客户端默认就开着);备份要演练——没恢复过的备份等于没有备份。
五、中文环境三件套
这三个问题在英文社区存在感弱,但在中文环境是稳定流量入口。
中文/emoji 存不进去:Incorrect string value
根因一句话:MySQL 的 utf8 是历史遗留的 3 字节实现(真名 utf8mb3),存不了 emoji 等 4 字节字符;新库新表一律用 utf8mb4。
排查四层——库、表、列、连接,任何一层不一致都会出问题:
-- 看表和列的真实字符集
SHOW CREATE TABLE mytable;

-- 看当前连接的字符集(乱码时先看这里)
SHOW VARIABLES LIKE 'character_set%';

-- 老表改造(注意:CONVERT 会锁表并重建,大表按第四章的 DDL 流程走)
ALTER TABLE mytable CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci;
连接层:客户端连接串加 charset=utf8mb4(或 JDBC 的 characterEncoding=UTF-8),命令行会话 SET NAMES utf8mb4;。
连带坑:utf8mb4 下每字符最多 4 字节,VARCHAR(255) 的索引长度是 1020 字节,老版本(767 字节上限)会报 ERROR 1071——这就是网上教程里 VARCHAR(191) 魔法数字的来历。5.7+/8.0 默认 DYNAMIC 行格式下上限已是 3072 字节,新环境不用再管 191。
时间差 8 小时:serverTimezone 问题
典型场景:Spring Boot + MySQL 8 驱动,存的时间查出来差 8 小时。根源是 JDBC 驱动按 UTC 处理会话时区:
# 连接串指定时区(connector 8.x 参数名是 connectionTimeZone,serverTimezone 仍兼容)
jdbc:mysql://host:3306/mydb?connectionTimeZone=Asia/Shanghai
同时核对服务端:SELECT @@global.time_zone, @@session.time_zone;(SYSTEM 表示跟操作系统走)。存储选型上:TIMESTAMP 存储时做时区转换,DATETIME 原样存储——跨时区业务用 TIMESTAMP,纯本地时间(生日、日程)用 DATETIME,混用是差 8 小时问题的另一半根源。
排序规则冲突:utf8mb4_0900_ai_ci
8.0 的 dump 导回 5.7 会报 Unknown collation: 'utf8mb4_0900_ai_ci'(单题 41 万浏览)。跨版本迁移时要么统一目标端版本,要么把 dump 里的排序规则批量替换成 5.7 认识的 utf8mb4_general_ci——但要接受两种排序规则对中文排序、大小写敏感度的行为差异,关联查询两端表的排序规则必须一致。
六、日常运维清单
binlog 把磁盘打满
SHOW BINARY LOGS;                          -- 看每个 binlog 文件多大
SHOW SLAVE STATUS;                         -- 有从库先确认从库消费到哪了
PURGE BINARY LOGS TO 'mysql-bin.000130';   -- 只删从库已消费的
SET PERSIST binlog_expire_logs_seconds = 604800;  -- 自动过期 7 天
⛔ 永远不要 rm 物理删除 binlog 文件——索引文件不同步,实例起来就报错。云 RDS 用控制台的日志上传/清理功能。
CPU 100% 应急
top # 确认是 mysqld 在吃
SHOW PROCESSLIST; # 抓正在跑的 SQL,重点看 Time 大、State 为 Sending data/Copying to tmp table 的行
然后回溯慢日志定位到具体 SQL——CPU 高的根因绝大多数是一条或多条全表扫描/大排序。修复优先级:加索引 → 改 SQL → 参数(排序内存、连接数)。
大表批量删除:分批 + 短事务
一次 DELETE 三千万行 = 超大事务 = 主从延迟 + undo 膨胀 + 长时间持锁。分批是纪律:
-- 每批 1000~5000 行,循环执行,批间提交
DELETE FROM logs WHERE create_time < '2026-01-01' LIMIT 2000;
-- 影响行数小于批大小时结束循环
备份工具选一句话版
mysqldump:中小库(几个 GB 内),逻辑备份,恢复慢;InnoDB 记得加
--single-transaction避免锁表;XtraBackup:大库物理备份,热备,恢复快;
Clone Plugin(8.0.17+):官方物理克隆,搭从库/快速重建首选。
七、面试四件套:一句话版(实操也用得上)
中文社区 MySQL 流量里有相当比例是面试驱动("追命连环问"式标题自成生态)。这四个理论题在生产排查中都有直接对应物,值得每个写 SQL 的人掌握:
为什么用 B+ 树:矮胖树形(3~4 层撑千万行,磁盘 IO 少),叶子节点成链表,范围查询顺藤摸瓜——这就是为什么你的范围条件
create_time > x AND < y能走索引。MVCC:undo log 版本链 + ReadView,让读不阻塞写。RR 级别在事务第一次快照读时生成 ReadView,RC 每条语句重新生成——这是"同一事务里两次读不一样"类问题的答案钥匙。
redo / undo / binlog 三大日志:redo 保崩溃恢复(物理页),undo 保回滚和 MVCC,binlog 保复制和时间点恢复(逻辑)。两阶段提交保证 redo 与 binlog 不脱节——误删恢复能成立,靠的就是 binlog。
隔离级别:InnoDB 默认 RR,互联网公司常改 RC(减少间隙锁,死锁更少)——你团队的默认值,直接决定第三章里死锁的概率。
排查方法论:五步走
具体问题千千万,路径只有一条:
读报错码——MySQL 的错误码设计就是给人查的,2002/1045/1130/1205/1213 各自指向明确;
定层——网络层(能不能通)、认证层(让不让进)、服务层(服务活着吗)、SQL 层(执行计划)、锁层(谁堵谁);
看现场——
SHOW PROCESSLIST、错误日志、SHOW ENGINE INNODB STATUS,永远先拿事实再动手;定根因——EXPLAIN、锁等待视图、binlog,用证据链说话;
修复 + 验证 + 留闸——改完要验证(执行计划、耗时、行数),并且把防复发的措施留下(安全模式、备份演练、监控告警)。
数据来源与延伸阅读
本手册的问题清单与热度数据来自两个方向的实测调研(2026-08-25,Stack Exchange 数据经官方 API 抓取):
相关主题
MySQL 连接报错速查(2002 / 1045 / 1130 / 2059 / 1040 / 2006)
慢查询三板斧(慢日志 → EXPLAIN → 索引/改写/参数)
锁与死锁定位(innodb_trx / sys.innodb_lock_waits / LATEST DETECTED DEADLOCK)
误删恢复(binlog2sql / MyFlash / 全量 + 增量重放)
中文环境(utf8mb4 / serverTimezone / 排序规则)

评论